TryOnDiffusion

3周前发布 641 0 0

Tryon Diffusion 是一个实时演示项目,尤其适用于虚拟试穿场景。它不仅迅速将用户的想法转化为精美的艺术作品,而且提供了丰富的资源。这类技术的另一个优点就是能提供充满活力的风格和颜色多样。用户可以尝试各种不同的艺术风格,使其快速地对自己的作品感受良好。 此项目在GPU性能方面具有较高的要求,因为合成高分辨率图像通常要求大量计算资...

语言:
zh
收录时间:
2026-08-31
TryOnDiffusionTryOnDiffusion

Tryon Diffusion 是一个实时演示项目,尤其适用于虚拟试穿场景。它不仅迅速将用户的想法转化为精美的艺术作品,而且提供了丰富的资源。这类技术的另一个优点就是能提供充满活力的风格和颜色多样。用户可以尝试各种不同的艺术风格,使其快速地对自己的作品感受良好。 此项目在GPU性能方面具有较高的要求,因为合成高分辨率图像通常要求大量计算资源。有关错误信息与性能方面的讨论可在 GitHub 上找到,例如有关“CUDA out of memory”问题。这类问题可以通过调整参数及参考文档中的内存管理和 Disco 变分技巧进行解决。 总之,Tryon Diffusion 是一个实时演示项目,旨在利用先进的潜在扩散技术和算法创作出高质量的虚拟试穿体验。该技术不仅具有颠覆性创新潜力,而且对于广泛行业领域的应用具有极大价值。
数据统计

相关导航

MoliliClaw

MoliliClaw

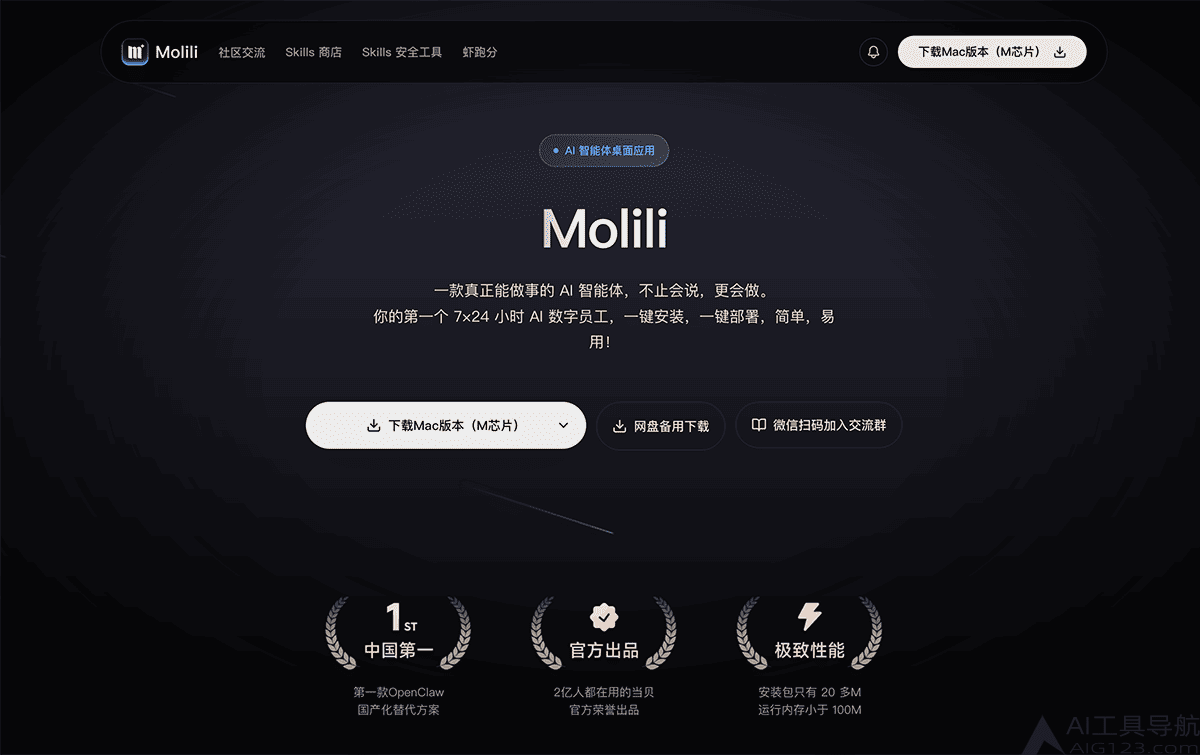
MoliliClaw(莫哩哩)是当贝推出的一款AI自主智能体,基于OpenClaw进行了深度本土化重构,定位为“7×24小时AI数字员工”。MoliliClaw支持客户端一键安装,普通用户无需任何技术背景即可完成部署,低配设备也能稳定运行,底层接入DeepSeek、MiniMax、通义千问等国产大模型,深度优化中文逻辑,能够精准理解复杂中文指令,同等指令Token消耗相较原版降低约五成。MoliliClaw搭配官方八千余项预置技能,可以帮助用户完成文档管理、网页采集、数据处理、系统维护等全流程自动化作业,支持通过微信、钉钉、飞书等移动端远程下发指令。
Video-LLaVA

Video-LLaVA

一个基于深度学习的视频超分辨率(SR)和视频增强(VE)框架,由北京大学元培学院的研究团队开发。该框架旨在提高低分辨率视频的质量和视觉效果,使其更接近高分辨率视频。Video-LLaVA 采用了多尺度融合、残差学习、自适应注意力机制等技术,以提高视频超分辨率和视频增强的性能。 主要特点: 1. 多尺度融合:通过在不同尺度上进行特征融合,提高了模型对细节和全局信息的捕捉能力。 2. 残差学习:引入残差连接,使网络能够更好地学习输入和输出之间的映射关系。 3. 自适应注意力机制:根据输入视频的特点,自动调整注意力权重,使模型能够关注到更重要的区域。 4. 端到端训练:整个框架可以作为一个整体进行端到端训练,简化了模型的训练过程。 5. 支持多种视频格式:Video-LLaVA 支持多种常见的视频格式,如 YUV、RGB 等。