clone-voice

clone-voice

这是一个声音克隆工具,可使用任何人类音色,将一段文字合成为使用该音色说话的声音,或者将一个声音使用该音色转换为另一个声音。 使用非常简单,没有N卡GPU也可以使用,下载预编译版本,双击 app.exe 打开一个web界面,鼠标点点就能用。 支持 中、英、日、韩、法、德、意等16种语言,可在线从麦克风录制声音。 为保证合成效果,建议录制时长5秒到20秒,发音清晰准确,不要存在背景噪声。 英文效果很棒,中文效果还凑合。
7710
AudioSep

AudioSep

功能特点: 分离任何你描述的音频:AudioSep 具备先进的音频分离算法,可以将输入的音频文件中的不同声音源分离出来。你只需描述想要分离的声音类型或源音,AudioSep 就能够根据描述进行准确分离。 官方实现:AudioSep 是由官方团队开发和维护的,因此可以保证其质量和功能的稳定性。 开源许可证:AudioSep 使用的是 MIT 开源许可证,这意味着你可以自由使用、修改和分发该工具。 易于使用:无论你是专业的音频处理人员还是新手,AudioSep 都提供了简单易用的界面和指令,让你能够快速上手并进行音频分离操作。 高度可定制:AudioSep 提供了丰富的参数和选项,可以根据你的需求进行各种调整和定制,以获得最佳的分离效果。
7610
呦呦有声

呦呦有声

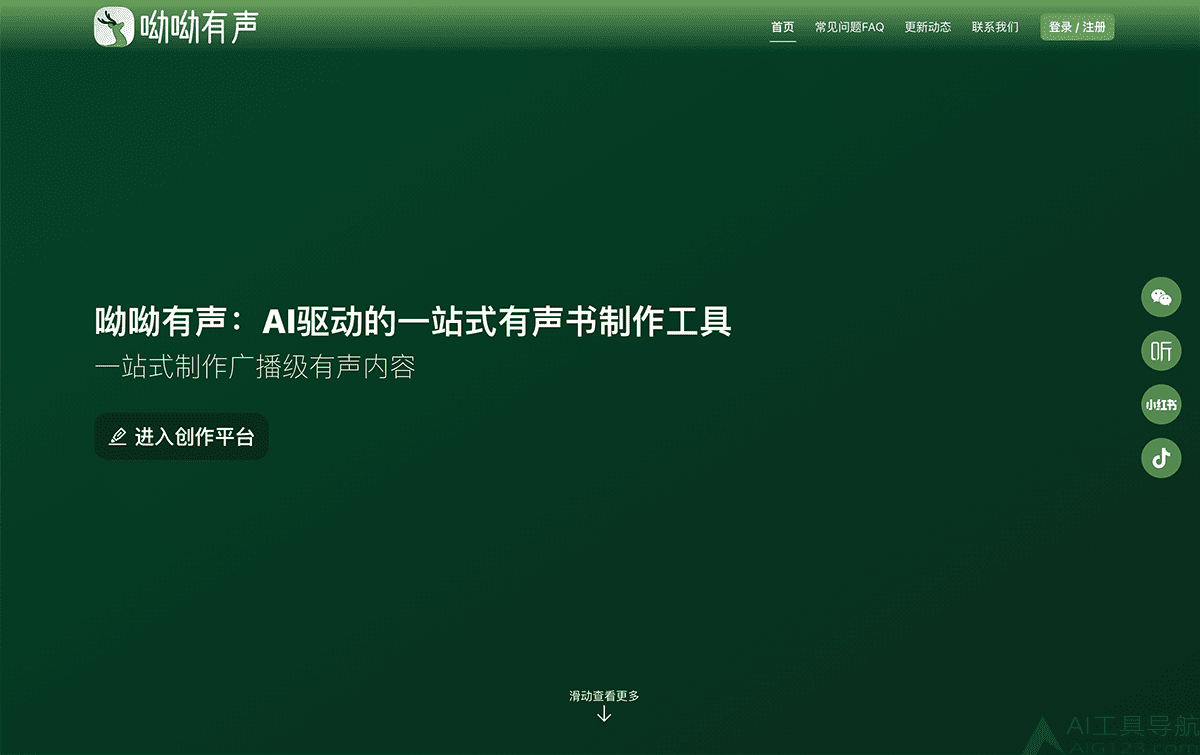
「呦呦有声」是一款AI驱动的一站式有声书全流程制作工具,覆盖从文本画本到成品音频的完整链路,专为有声书制作团队打造。「呦呦有声」将有声书制作拆解为 6 大核心环节——画本编辑、在线配音、智能对轨、专业审听、后期处理和项目统筹,并在一个平台上实现全链路闭环协作。无论是个人创作者还是多人剧组团队,都能高效完成有声书从文本到成品的全部制作。
7410
声音克隆So-VITS-SVC 4.0 翻译站点

声音克隆So-VITS-SVC 4.0 翻译站点

在B站上,AI孙燕姿翻唱的林俊杰《她说》、周董《 发如雪 》《 爱在西元前 》、赵雷《成都》等等,让一众网友深陷无法自拔。网友表示,听了一晚上AI孙燕姿,出不去了…… 这些翻唱作品基于一个叫做so-vits-svc的开源项目。仅凭数段音频, 就可用一个生成式模型来合成目标音色的音频,训练出用户想要的声学模型。这个模型可以保留音高和音调,也可以用不同的语言来翻唱。 主要使用的是So-VITS-SVC 4.0这个项目,github地址是: https://github.com/svc-develop-team/so-vits-svc 目前B站有两个作者做的整合包分别是羽毛布団的和领航员未鸟的我把视频地址都放在下面。希望各位去视频给个三连毕竟用了人家的劳动成果。 羽毛布団:【AI翻唱/SoVITS 4.0】手把手教你老婆唱歌给你听~无需配置环境的本地训练/推理教程[懒人整合包] https://www.bilibili.com/video/BV1H24y187Ko/ 领航员未鸟:【Sovits4.0一键包】快领走属于你自己的AI歌姬吧!AI翻唱训练教学 https://www.bilibil
7410
AI gpt中转站支持GPT-4、Claude3

AI gpt中转站支持GPT-4、Claude3

当前支持的模型: ✅GPT-3.5 所有版本以及 Embedding 官方接口:支持最新 gpt-3.5-turbo-0125、text-embedding-3-large、text-embedding-3-small 模型。 ✅GPT-4 所有版本官方接口:支持最新 gpt-4-0125-preview、gpt-4-turbo-preview、gpt-4-1106-preview、gpt-4-vision-preview 等模型 ✅GPT-4-32K 所有版本官方接口(32K 系列为老模型,价格贵)。 ✅OpenAI 文本转语音模型:tts-1、tts-1-1106、tts-1-hd、tts-1-hd-1106 ✅OpenAI 语音转文本模型:whisper-1 ✅OpenAI embedding 模型:text-embedding-ada-002、text-embedding-3-small、text-embedding-3-large(官网原价渠道,实际价格及倍率对标原价) ✅Claude3 模型:claude-2、claude-3-opus-20240229、claude-3-
7410