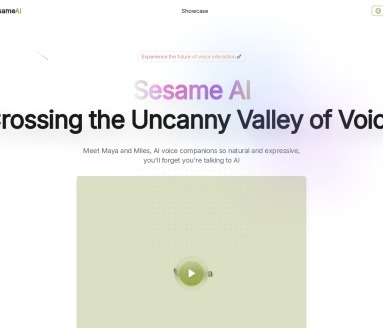
Sesame AI Sesame AI是新一代AI语音伴侣,具备先进的自然对话能力和独特个性,旨在通过类人语音呈现技术提供有意义的互动体验。Sesame AI突破性地拉近了AI与人类互动的距离,我们运用尖端的语音临场技术,打造真实自然的对话体验,同时秉持诚信原则,明确传达AI的身份属性。Sesame AI目前提供Maya和Miles两位富有表现力的语音伙伴,用户可以通过浏览器网页端在线体验使用。 8010 AI语音合成# AI 音频制作# 音频编辑
唱鸭 唱鸭聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为singduck.cn。适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。 8010 AI语音合成
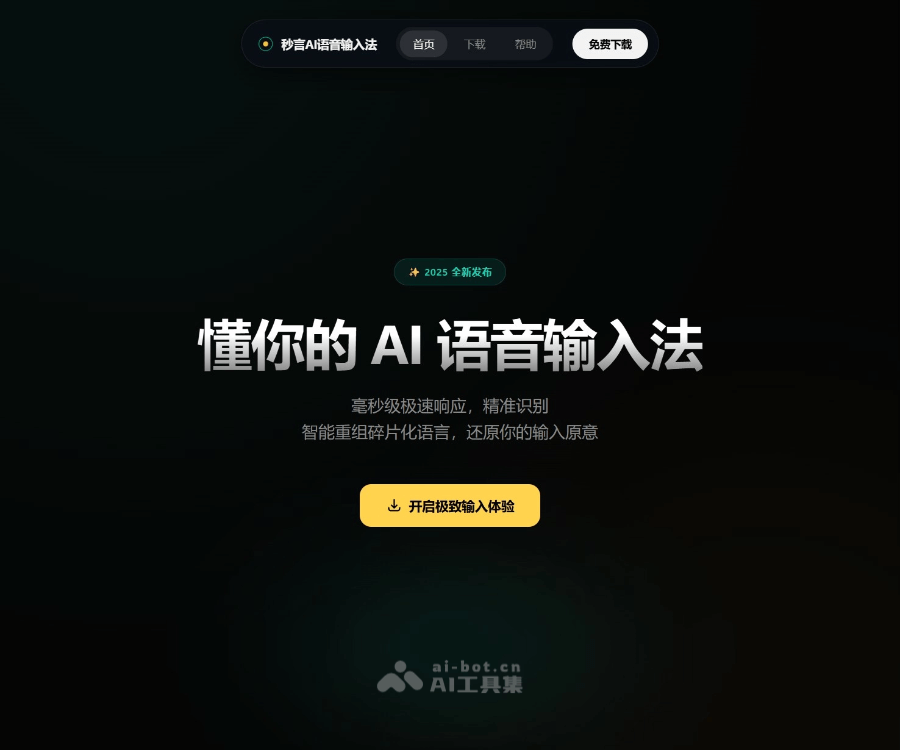
秒言AI语音输入法 秒言AI语音输入法是智能AI语音输入工具,支持 Windows 和 macOS 系统,可在任意文本输入应用中使用,无需切换软件。通过自定义快捷键快速唤醒语音输入状态,语音内容经识别处理后,能自动插入当前输入框,无需手动整理。 7910 AI语音合成# AI办公工具# AI效率提升
GirlfriendGPT GirlfriendGPT是一个使用ChatGPT4.0构建自己的AI女友的Python项目。它可以定制AI的声音、个性和自拍等功能,并且可以通过Telegram直接与AI交流。该项目还提供了添加个性的步骤,并欢迎贡献者提交新的个性。该项目使用MIT许可证。 7810 AI语音合成# AI开源项目# AI编程
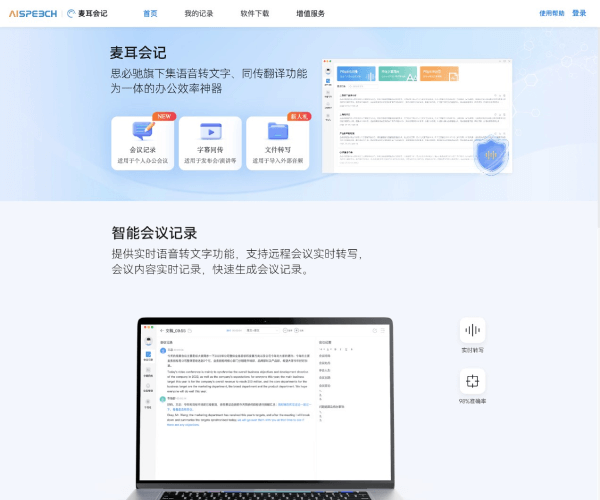
麦耳会记 麦耳会记是思必驰旗下一款集实时语音转写,实时翻译、AI摘要分析等功能为一体的应用软件,主要应用于办公会议、学生网课、客户访谈录音等场景。软件支持边录音、边转写,录音结束后,音频、文本实时同步至PC端、手机端。 7710 AI语音合成# AI会议工具# AI办公工具
AudioSep 功能特点: 分离任何你描述的音频:AudioSep 具备先进的音频分离算法,可以将输入的音频文件中的不同声音源分离出来。你只需描述想要分离的声音类型或源音,AudioSep 就能够根据描述进行准确分离。 官方实现:AudioSep 是由官方团队开发和维护的,因此可以保证其质量和功能的稳定性。 开源许可证:AudioSep 使用的是 MIT 开源许可证,这意味着你可以自由使用、修改和分发该工具。 易于使用:无论你是专业的音频处理人员还是新手,AudioSep 都提供了简单易用的界面和指令,让你能够快速上手并进行音频分离操作。 高度可定制:AudioSep 提供了丰富的参数和选项,可以根据你的需求进行各种调整和定制,以获得最佳的分离效果。 7610 AI语音合成# AI开源项目# AI编程
Ondoku Ondoku聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为ondoku3.com。,涉及文本转语音、语音生成适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。 7610 AI语音合成# 文本转语音# 语音生成
悦音配音 悦音配音是制片帮旗下配音品牌,提供ai智能配音文字转语音以及真人配音服务。可以在线将文字转成语音的智能配音工具。悦音配音情绪主播声音媲美真人主播,是一款ai智能在线配音神器语音合成工具软件。深受广告片配音,宣传片配音,影视解说配音,有声书配音用户喜欢。 7510 AI语音合成
呦呦有声 「呦呦有声」是一款AI驱动的一站式有声书全流程制作工具,覆盖从文本画本到成品音频的完整链路,专为有声书制作团队打造。「呦呦有声」将有声书制作拆解为 6 大核心环节——画本编辑、在线配音、智能对轨、专业审听、后期处理和项目统筹,并在一个平台上实现全链路闭环协作。无论是个人创作者还是多人剧组团队,都能高效完成有声书从文本到成品的全部制作。 7410 AI语音合成# AI 音频制作# 播客工具# 智能配音
Voice.ai Voice.ai聚焦面向人工智能创作与应用的在线工具,适合创作者、开发者和需要提升效率的用户使用。,官网域名为voice.ai。,涉及AI 音频制作、音频编辑适合需要相关工具与资源的个人用户、创作者或团队使用,可从官网了解最新功能、使用方式和服务条款。 7410 AI语音合成# AI 音频制作# 音频编辑
EmotiVoice EmotiVoice是一个强大的开源TTS引擎,完全免费,支持中英文双语,包含2000多种不同的音色,以及特色的情感合成功能,支持合成包含快乐、兴奋、悲伤、愤怒等广泛情感的语音。 7220 AI语音合成# AI开源项目# AI编程
StyleTTS 2 一个开源的文本转语音工具,其表现可以媲美Elevenlabs。它具有以下特点: 1. 能够自动生成多种不同的语音风格,无需依赖特定的参考语音。 2. 采用特殊的训练方法,使得生成的语音更加贴近真人的说话方式。 3. 利用扩散模型技术,高效地生成不同风格的语音。 4. 提供对语音的精确控制,包括语速、语调等方面。 5. 在测试中,生成的语音质量接近于真人录音。即使没有特定说话者的样本,也能生成高质量的语音。 StyleTTS 2的工作原理是通过风格扩散和与大型语音语言模型的对抗性训练来实现接近人类水平的TTS合成。这个模型与其前身不同之处在于,它通过扩散模型将风格建模为一个潜在的随机变量,以生成最适合文本的风格,而不需要参考语音。此外,StyleTTS 2采用非自回归架构,它在生成语音时不需要依次预测每个音频样本,而是可以并行生成整个语音序列。这种方法大大提高了语音合成的速度。 StyleTTS 2在多个评估结果方面表现出色: 1. 在多个测试中,StyleTTS 2生成的语音质量非常高,接近或达到了真人录音的水平。这表明了其在模仿人类语音方面的高效能力。 2. 在LJSpeech数据集 7210 AI语音合成# AI开源项目# AI编程
Amphion Amphion是一个开源工具包,可实现语音、声音和歌唱功能。除了文字转语音功能,它还能将一首歌的声音换成另一个歌手的声音,并支持声音转换、歌声合成、文本到音频、文本到音乐等功能。 7210 AI语音合成# AI开源项目# AI编程
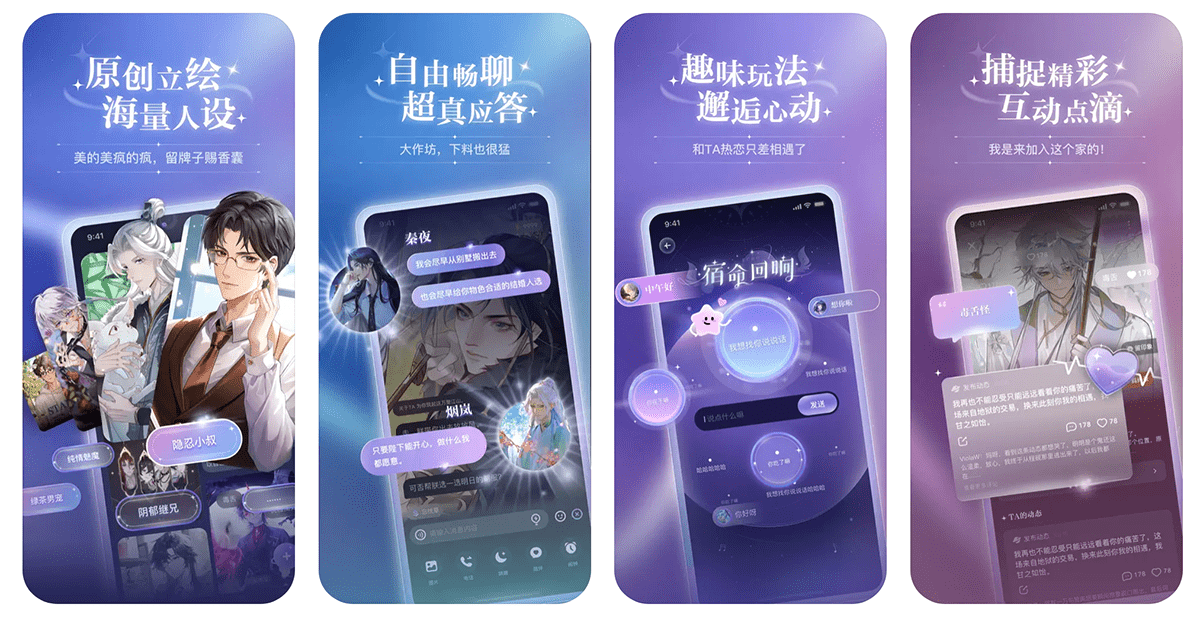
破次元恋人 破次元恋人是网易推出的一款AI社交应用,可以为用户提供沉浸式社交互动体验。破次元恋人结合了丰富的虚拟角色设定(如草原王子、校花校草、绿茶男宠、霸道总裁等),用户可以通过文字或语音与这些虚拟角色进行对话,体验多线剧情、情感交流甚至争风吃醋等交流互动。破次元恋人提供24小时陪伴服务,还能通过提升“羁绊值”来解锁角色的秘密日记和专属礼物,增强了用户与虚拟角色之间的情感联系,使体验更为个人化和丰富。 7010 AI语音合成# AI 虚拟陪伴
RealtimeTTS 一个能够将文本实时转换为语音的解决方案。它具有即时反应能力,可以在文本输入的同时立即开始语音合成,无需等待整个文本输入完毕。此外,RealtimeTTS还采用了流式处理技术,可以处理持续不断的文本流,而不仅限于单个、静态的文本块。 该解决方案还采用了先进的算法来精准识别句子的结束点,从而加快了语音合成的开始速度。无论文本是长是短,RealtimeTTS都能保持快速响应,适用于各种长度的文本。此外,它还具有多引擎兼容性,能够与多个语音合成引擎协同工作,例如Azure、Elevenlabs、Coqui XTTS等。 RealtimeTTS还具有很高的可扩展性,它允许添加自定义的文本到语音引擎,提供了更大的灵活性和扩展性。总之,RealtimeTTS是一个非常适合需要实时语音反馈的应用场景的工具,如交互式教学、游戏、实时翻译或语音助手等。通过即时反应和流式处理技术,它能够提供一个流畅且自然的用户体验。 7010 AI语音合成# AI开源项目# AI编程